مرصد حوسبة العربيَّة لعام (٢٠٢٥م) مرجعك في مستجدَّات الحوسبة العربيَّة
مرحبًا بكم في الإصدار الأول من (مرصد حوسبة العربيَّة)
أبرز الخلاصات:
فصول التقرير
يظهر الرَّسم البيانيُّ توزيع أدوات المعالجة الآليَّة للُّغة العربيَّة بحسب تاريخ نشرها، وتُلاحَظ محدوديَّة الأدوات في السَّنوات الأولى: (من ٢٠١٦م، حتَّى ٢٠٢٠م)؛ إذ لم يتجاوز العدد في أيٍّ من هذه الأعوام (٩) أدواتٍ، ثمَّ بدأ العدد يرتفع تدريجيًّا مع بداية عام (٢٠٢١م)، حتَّى بلغ ذروته عام (٢٠٢٤م)؛ إذ نُشِرت فيه (٣٢) أداةً، وهذا النُّمو الكبير يعكس ازدياد الاهتمام بتطوير أدوات المعالجة الآليَّة للُّغة العربيَّة.
يعرض الرَّسم البيانيُّ توزيع أدوات المعالجة الآليَّة للُّغة العربيَّة بحسب قابليَّة الوصول إلى رمز الاستجابة المباشر (الكود)؛ إذ يظهر أن غالبيَّة الأدوات هي مشروعات مفتوحة المصدر (٧٥.٠%)؛ ممَّا يعكس الاتجاه السَّائد في المجتمعين الأكاديميّ والصِّناعيّ، نحو الانفتاح والمشاركة، وتكمن أهميَّة هذا التَّوجُّه في تيسير الوصول إلى الأدوات؛ تعزيزًا للتَّعاون بين الباحثين والمطوِّرين. وفي المقابل توجد فجوة بين الأدوات المتاحة للأبحاث والمشروعات المغلقة، وهو ما يظهر في نسبة الأدوات المغلقة (١٥.٢%)، وأدوات التَّواصل مع المالكين (٩.٨%).
يوضِّح الرَّسم البيانيُّ توزيع دعم الأدوات للَّهجات بحسب تنوُّع المهام، ويُلاحَظ أنَّ أدوات الفصحى الحديثة تتفوَّق في معظم المهام، خاصَّةً في أدوات التَّحليل النَّحويِّ، وأدوات التَّصنيف النَّصيِّ، وأدوات توليد النُّصوص. بينما تظهر اللَّهجات في الرَّسم البياني حضورًا أقلَّ من الفصحى الحديثة والفصحى التُّراثيَّة؛ رغم وجودها في بعض المهام، مثل: أدوات التَّصنيف النَّصيِّ، وأدوات التَّعرُّف إلى الكلام صوتيًّا؛ وهذا يظهر الحاجة إلى تطوير أدوات للَّهجات العربيَّة خاصَّةً في مجالات تحليل النُّصوص المتنوِّعة.
يوضِّح الرَّسم البياني توزيع أدوات المعالجة الآليَّة للُّغة العربيَّة بحسب منصَّة الاستضافة. وتُلحَظ استضافة غالبيَّة الأدوات على منصَّة (قت هب) بنسبة (٦٦.١%)؛ ممَّا يُيَسِّر الوصول إليها ومشاركتها مع الباحثين والمطورين، ثمَّ تليها الأدوات المُستضافَة على منصَّات الشَّبكة بنسبة (٢٥.٩%). أمَّا الأدوات المُستضافَة على منصَّات أخرى فتشكِّل نسبةً ضئيلةً هي: (٨%).
يوضِّح الرَّسم البياني توزيع أكثر عشر مهام في البيانات اللُّغويَّة العربيَّة، ويُلاحَظ أنَّ (الترجمة الآليَّة) هي المهمة التي نُشِر لها أكبر عدد من مجموعات البيانات، ومقدارها (١٥٢) مجموعة بيانات، تليها مهمَّة (التَّعرُّف إلى الكلام) بـ (٩٥) مجموعة، وتظهر مهام أخرى، مثل: (استرجاع المعلومات)، و(نموذج اللُّغة)، و(إنشاء النَّص) في مراتب متقدِّمة. ويتضِّح أنَّ الأبحاث في هذه المهام تتمحور بشكل رئيس حول التَّطبيقات العمليَّة، مثل: التَّرجمة، والتَّعرُّف إلى الكلام، بينما تُعَدُّ المهام الأخرى أقلَّ انتشارًا، ولكنَّها لا تزال مهمةً في تطوير التَّطبيقات.
يوضِّح الرَّسم البياني توزيع البيانات بحسب اللَّهجات. تركِّز معظم البيانات على اللُّغة العربيَّة الفصحى؛ إذ تظهر مجموعات بيانات كبيرة للفصحى الحديثة، ويظهر أيضًا أنَّ اللَّهجة المصريَّة هي الأكثر انتشارًا، تليها اللَّهجات الأخرى، مثل: اللَّهجة الخليجيَّة. من ناحية أخرى، تُلَاحظ قلَّة الاهتمام ببعض اللَّهجات، مثل: اللَّهجات الموريتانيَّة، والجيبوتيَّة، والصُّوماليَّة، ويُلاحَظ أيضًا وجود مجموعات بيانات مختلَطة تحوي أكثر من لهجة، تُستخلَص غالبًا من وسائل التَّواصل الاجتماعي، وتشير البيانات أيضًا إلى تصنيف خاصٍّ للبيانات المتعلِّقة ببلاد الشَّام والمغرب العربي.
يوضِّح الرَّسم البياني توزيع النَّماذج بحسب نوعها على . موقع .(HuggingFace) تركِّز (٣٨%) من النَّماذج على مهمَّات توليد النُّصوص، ويظهر أنَّ هناك حوالي (٩٠) نموذجًا مخصَّصًا لقياس درجة التَّشابه بين النُّصوص المختلفة. وتتنوَّع بقية المهمَّات بين التَّرجمة، والتَّصنيف النَّصي، ونماذج إعادة الصِّياغة، وغيرها من المهمَّات المتخصِّصة.
يوضِّح الرَّسم البياني تصنيف مجموعات المهام والبيانات في مؤشِّر أوركا (ORKA). ويحوي المؤشِّر (٧) مهمَّاتٍ رئيسةٍ، موضَّحة في الشكل (٣). تحتوي مهمَّة تصنيف الجمل على: (تحليل المشاعر (SA)، والمعنى الاجتماعي (SM)، وإكمال الحوار (Dia-C)، وتوليد استجابات الحوار(Dia-R)، وكشف تعطُّل الحوار (Dia-B)، وتنبؤ الادعاء (CL)، والتَّوليد الآلي (MG)). وتحتوي مهمَّة التنبؤ الهيكلي على: (وسم أقسام الكلام (POS)، والتَّعرُّف إلى الكيانات المسمَّاة (NER)). في حين تحتوي مهمَّة الاستدلال اللُّغوي على: (الاستنتاج اللُّغوي الطَّبيعي متعدِّد اللُّغات (XLNI)، والتَّحقُّق من الحقائق (FC))، وتحتوي مهمة التَّشابه الدلالي للنُّصوص على: (تشابه النُّصوص الدلالي (STS)، وتشابه النُّصوص الدلالي للأسئلة (QSTS). وتمثِّل القيمة بين قوسين عدد مجموعات البيانات في كلِّ مجموعة مهمَّات.
يوضِّح الرَّسم البياني تصنيف مجموعات المهمَّات في مؤشِّر دولفين .(Dolphine) وتتصدَّر الفصحى المعاصرة في مهمَّات، مثل: (التَّرجمة الآليَّة) و(الإجابة عن الأسئلة)، بينما تتصدَّر اللَّهجات ف في مهمَّات (التَّرجمة الآليَّة)، و(التَّبديل بين اللَّهجات).
يعرض الرَّسم البياني توزيع المستويات التَّعليميَّة والموضوعات المقابلة في مؤشِّر (ArabicMMLU). صُنِّفت الموضوعات بمرونة؛ إذ تعكس تنوُّع اهتمامات الأكاديميين والطلاب في المجالات المختلفة، وهذه التَّصنيفات مفيدة في عمليَّات البحث الأكاديمي، أو تخطيط المناهج الدراسيَّة.
يوضِّح الرَّسم البياني توزيع البيانات في مؤشر (بَلْسَم) عبر الفئات المحدَّدة. ويُلاحَظ أنَّ الفئات الكبرى، هي: (الكتابة الإبداعيَّة)، و(الإجابة عن السؤال)، و(التَّرجمة الآليَّة)؛ إذ تشكِّل جزءًا كبيرًا من الفئات الموجودة في المؤشِّر؛ ممَّا يعكس تركيزًا كبيرًا على المهمَّات المتعلِّقة بإنتاج النُّصوص الإبداعيَّة والأدبيَّة. وتظهر فئات أخرى أيضًا، مثل: (الملخص)، و(تلاعب النَّص)، و(تنفيذ البرنامج)، التي تمثِّل مهمَّاتٍ فرعيَّةً تُستخدَم في المعالجة الآليَّة للنُّصوص.
يوضح الرَّسم البياني عدد طلبات براءات الاختراع المتعلقة بمعالجة اللُّغة منذ عام (٢٠١٤م) حتَّى عام (٢٠٢٤م)، وبدأ العدد يرتفع ارتفاعًا ملحوظًا في عام (٢٠٢١م)؛ إذ قُدِّمَت (١٠) طلبات، ويظهر أيضًا تراجع طفيف في السَّنوات الأخيرة (٢٠٢٣م-٢٠٢٤م)؛ إذ انخفض عدد الطلبات مرَّةً أخرى.
يوضح الرَّسم البياني عدد السَّاعات التدريبيَّة لكلِّ دورة تدريبيَّة في مجال الذَّكاء الاصطناعي ومعالجة اللُّغة الطبيعيَّة، يُلاحَظ ذروة واضحة في العدد عند السَّاعة (١٥)؛ إذ بلغ عدد السَّاعات التدريبيَّة (٣٠٠) ساعة، مع وجود تقلبات في باقي الأيام، والمتوسط العام لعدد السَّاعات التدريبيَّة للدَّورات، هو: (٣٠.٢٢) ساعة.
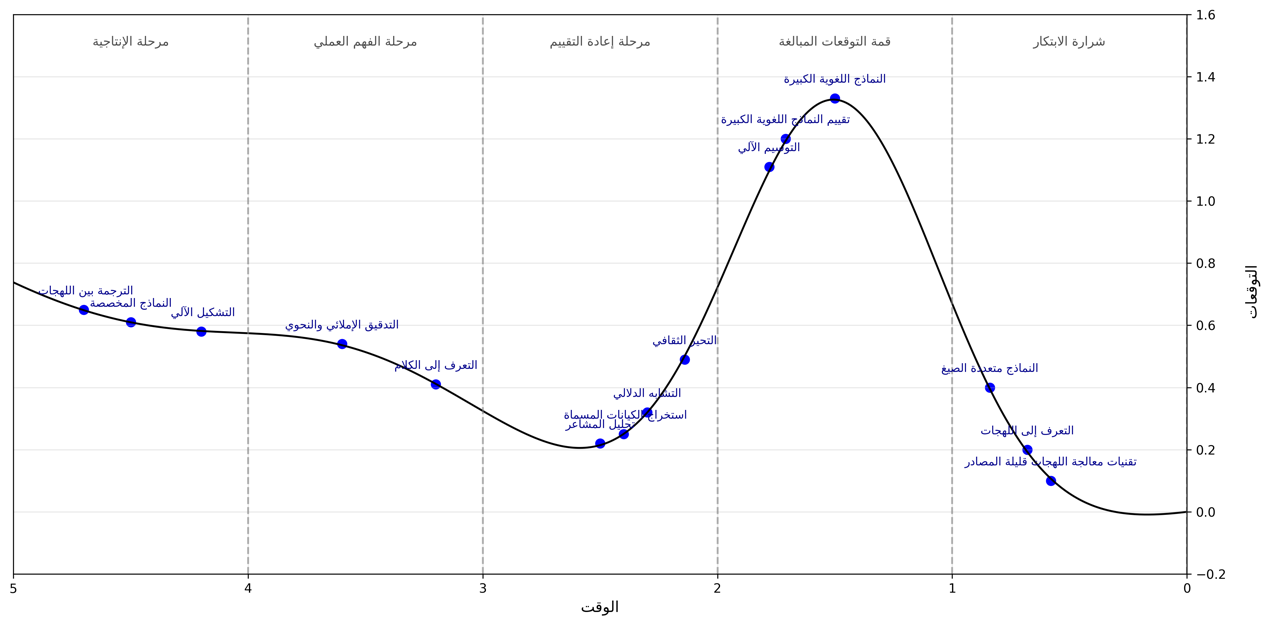
يعكس منحنى الضجة (Hype Cycle) لعام (2024م) مسار تطور تقنيات المعالجة الآلية للغة العربية، من الابتكار إلى التطبيق العملي، حيث شهد المجال تطلعات مرتفعة، تلتها تحديات تقنية، ثم استقرارًا في الحلول القابلة للتطبيق. برزت تقنيات مثل التعرف إلى اللهجات ومعالجتها بكفاءة الموارد، وبلغت التوقعات ذروتها مع إطلاق تسعة نماذج لغوية كبيرة، قبل إعادة التقييم بسبب تحديات كالتحيز الثقافي. ومع ذلك، استقرت بعض التقنيات الناجحة، مثل التدقيق الإملائي والتعرف إلى الكلام، ووصلت أخرى، كالنماذج المتخصصة والترجمة بين اللهجات، إلى مرحلة الإنتاجية، مما يعكس نضج المجال ويفتح فرصًا جديدة. ورغم هذا التقدم، لا تزال هناك تحديات تتطلب مزيدًا من البحث لضمان دقة هذه التقنيات وفاعليتها، مثل زيادة البيانات الموسّمة، ومعالجة التحيز اللغوي والثقافي في النماذج، ودعم اللهجات في الأدوات، ووضع قواعد أخلاقية لحماية البيانات، وتحسين البنية التحتية.
